Docker, Kubernetes et Ansible sont souvent réunis sous l’étiquette automatisation, mais ils ne répondent pas au même besoin. Les distinguer permet de composer une chaîne cohérente et d’éviter qu’un outil soit utilisé pour compenser l’absence de pratiques communes.
Trois rôles complémentaires
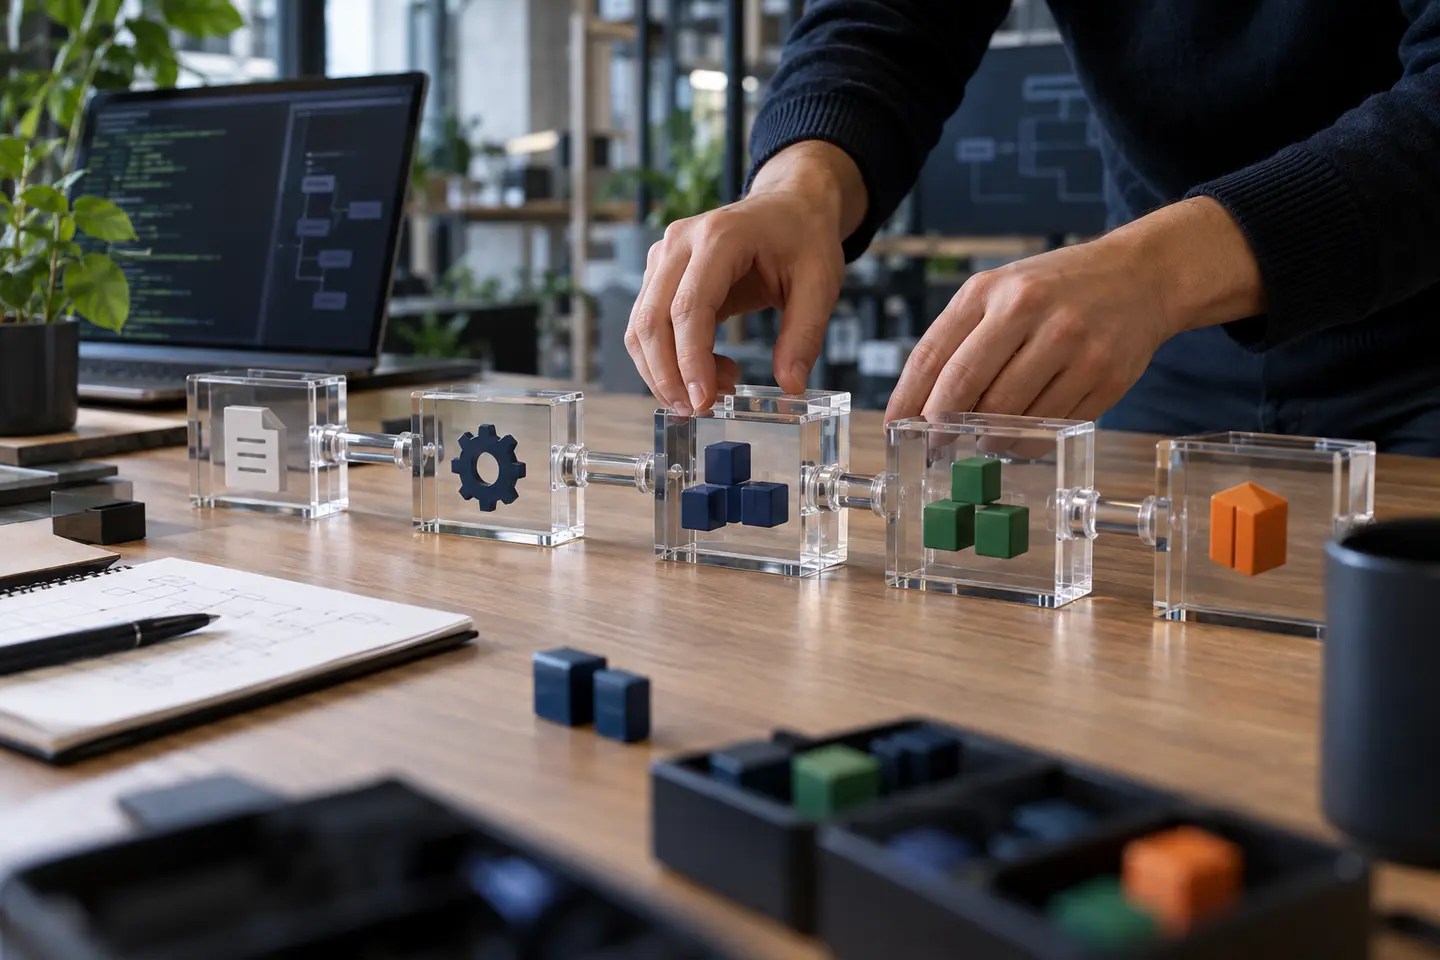
Docker construit et exécute des conteneurs : il standardise l’environnement de l’application. Kubernetes orchestre ces conteneurs sur un cluster : placement, redémarrage, exposition, configuration et montée en charge. Ansible automatise des opérations déclarées dans des playbooks : préparation d’hôtes, configuration de services, contrôles ou orchestration de tâches. Les frontières peuvent se croiser, mais une responsabilité principale claire facilite le diagnostic. Une image défectueuse ne se corrige pas dans Kubernetes, et un cluster mal conçu ne se résout pas avec un playbook supplémentaire.
Assembler une chaîne avec des contrats explicites
Le pipeline produit une image immuable, testée et identifiée. La plateforme Kubernetes fournit ensuite un mode de déploiement, des politiques, des secrets et de l’observabilité. Ansible peut préparer des dépendances externes, automatiser certaines opérations ou configurer des environnements qui ne relèvent pas du cluster. Chaque passage possède un propriétaire et des critères de réussite. Un cas d’usage de bout en bout, incluant incident et retour arrière, révèle mieux les lacunes qu’une démonstration séparée de chaque technologie.
À retenir
Docker empaquette, Kubernetes orchestre et Ansible automatise : la valeur vient des contrats qui relient ces responsabilités.
Pour approfondir
Documentation Docker ↗Documentation Kubernetes ↗Documentation Ansible ↗Article mis à jour le . La date de première publication est conservée.