Aller au contenu
01

Observabilité

Une promesse claire

Comprendre vite. Agir juste.

Conseil et expertise en supervision
et observabilité

ADN Consulting accompagne les entreprises à Lille, Nantes, Paris et à distance pour fiabiliser leurs services IT. Audit, intégration, migration, optimisation et exploitation : nous partons de vos outils et de vos difficultés pour définir les actions utiles.

Parlons de votre besoin

Lenteurs, incidents, coûts ou besoin d’expertise : échangeons sur votre priorité.

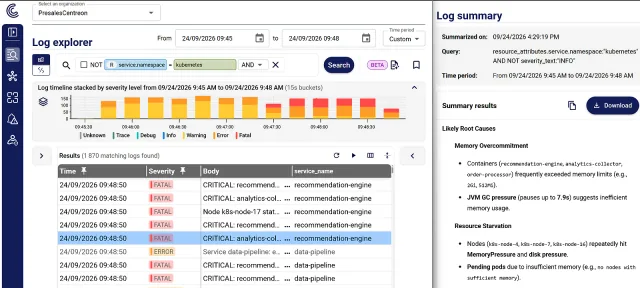
SUPERVISION & OBSERVABILITÉCentreon · Datadog
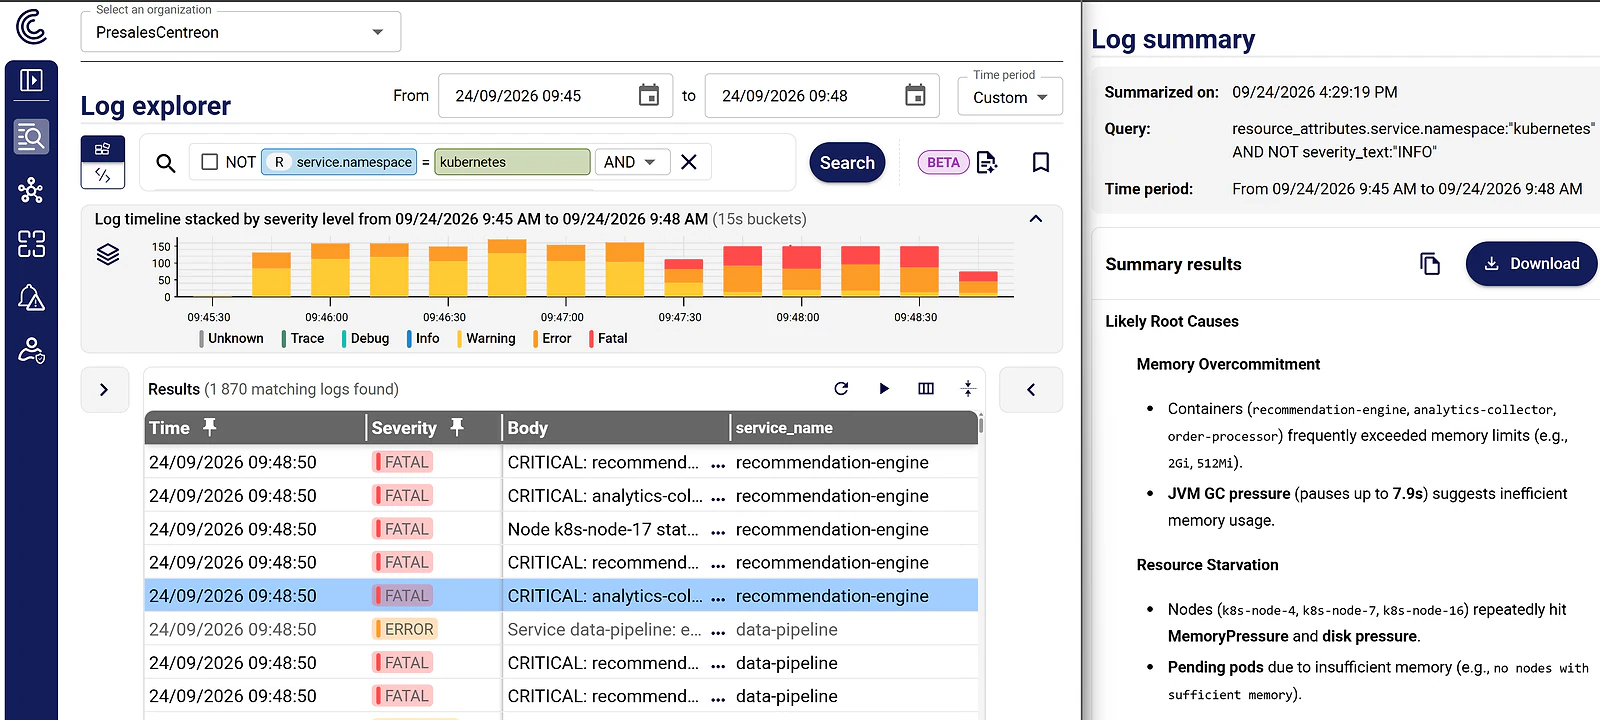
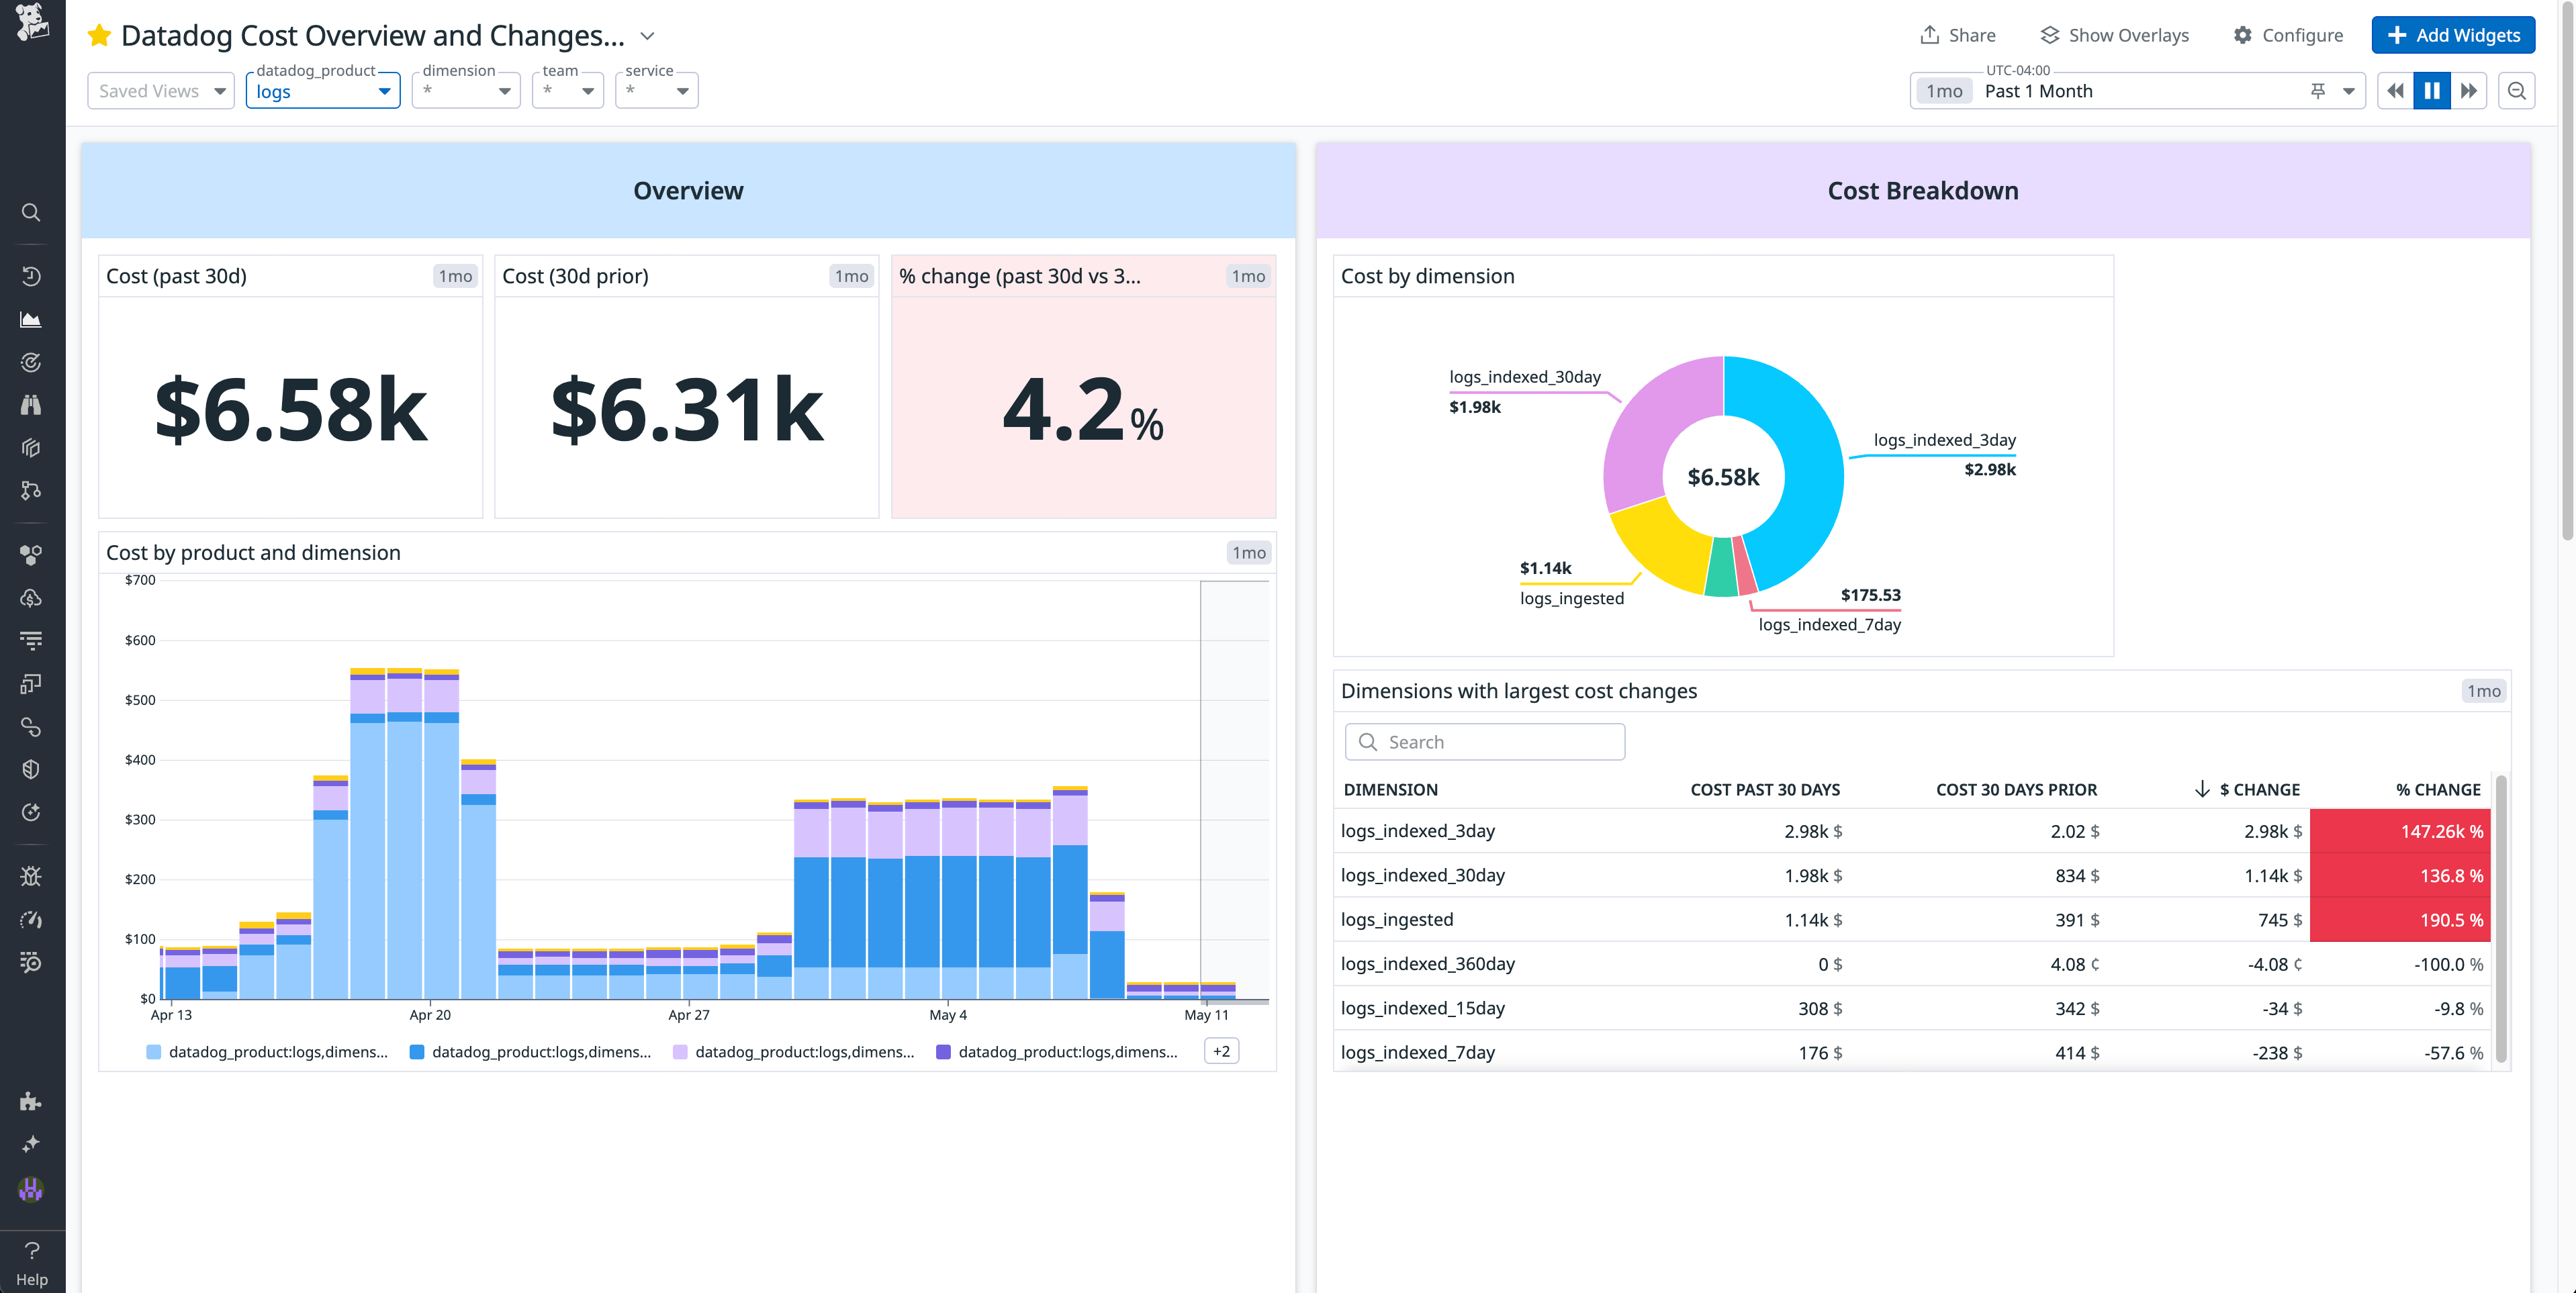
Captures d'interfaces éditeurs · Centreon & Datadog
02

Vos enjeux

Quelle est votre priorité ?

Vos applications ralentissent

Identifier les composants à investiguer et rapprocher les données techniques du parcours utilisateur.
Les incidents se répètent

Analyser les incidents récurrents et construire un plan d’amélioration du Run.

Trop d’alertes

Revoir les règles, réduire le bruit et prioriser selon l’impact métier.

Vos outils se multiplient

Identifier les recouvrements, les manques et les possibilités de rationalisation.

Vos coûts augmentent

Examiner les volumes collectés, la conservation et les usages pour proposer des optimisations.

Vous manquez d’expertise

Définir le renfort, l’accompagnement et le transfert de compétences adaptés.

03

Notre offre

Des objectifs et des livrables
1

OBSERVE START

Cadrer et prioriser

Audit de maturité, services critiques, incidents récents, couverture de supervision et coûts. Nous identifions les points aveugles et les premières actions utiles.

Livrables : Diagnostic, architecture cible et feuille de route.

Parlons de votre besoin START
2

OBSERVE BUILD

Instrumenter et déployer

Instrumentation applicative, collecte des signaux, intégration de la plateforme, tableaux de bord et alertes. Nous construisons un socle cohérent avec votre environnement.

Livrables : Collecte opérationnelle, vues de service et règles d’alerte.

Parlons de votre besoin BUILD
3

OBSERVE RUN

Mettre en exploitation

Procédures d’investigation, runbooks, escalades et transfert de compétences. Nous relions l’observabilité à vos pratiques de gestion des incidents.

Livrables : Documentation, responsabilités et équipes accompagnées.

Parlons de votre besoin RUN
4

OBSERVE CARE

Améliorer dans la durée

Revue du bruit d’alerte, indicateurs de fiabilité, volumes de données et coûts. Nous ajustons le dispositif à partir des usages et des incidents réellement rencontrés.

Livrables : Reporting, plan d’amélioration et arbitrages de collecte.

Parlons de votre besoin CARE

Nous définissons avec vous le périmètre, les livrables et les critères de recette. Pour une compétence ciblée, découvrez aussi notre accompagnement en renfort d’équipe.

Détail de notre méthode
04

Démonstration

Du signal à la décision

Du signal
à la décision

Une lecture rapide d'un ralentissement applicatif : du symptôme aux pistes d'investigation.

Faire le diagnostic

Données Datadog · Juin 2026

Temps de réponse (ms)2 5001 250010:0010:0510:1010:152 400 ms
Données illustratives. Un ralentissement est visible. Ce graphique seul n'en démontre pas la cause.

Un parcours utilisateur ralentit

Le temps de réponse augmente. C’est une information utile, mais elle ne dit pas encore quel composant examiner. La première étape consiste à situer l’événement et son périmètre.

Question suivante : quels services participent à ce parcours ?

Graphiques illustratifs de lecture et d’investigation.
Données Datadog · Juin 2026
05

Réalisations

Des preuves concrètes
06

Partenariats

Des éditeurs reconnus

Datadog Advanced et Centreon : nos partenariats, sources et réalisations

07

Technologies

Un écosystème maîtrisé
08

Travailler avec ADN

Selon votre organisation

Un projet défini

Un périmètre, des livrables et des critères de recette convenus ensemble : audit, intégration, migration ou optimisation.

Un renfort d’équipe

Une compétence ciblée pour accompagner votre équipe et transmettre les pratiques utiles.

Renforcer votre équipe

Un centre de services

Un périmètre d’exploitation, des responsabilités et des modalités de suivi à définir lors du cadrage.

09

Nos interventions

Lille · Nantes · Paris

ADN Consulting accompagne vos projets de supervision et d’observabilité sur site et à distance, selon le périmètre et les modalités convenus.

10

Pour aller plus loin

Accès rapide
Notre méthode et nos expertises techniques

Préparer les décisions et le passage au RUN

Choisir une plateforme

Définissez les services critiques, les contraintes de collecte et les scénarios de diagnostic. Comparez les solutions sur les mêmes critères : couverture, intégration, usage par les équipes et coût des volumes prévus.

Voir un programme de sélection et de déploiement Dynatrace

Préparer un audit

Réunissez un inventaire des outils, quelques incidents récents, les accès en lecture autorisés et les interlocuteurs responsables. Le cadrage fixe les services examinés et les livrables attendus : diagnostic, priorités et critères de vérification.

Préparer votre diagnostic

Arbitrer les coûts

Rapprochez les volumes facturés des usages réels. Évaluez les changements de collecte, de conservation et d’échantillonnage sur des scénarios d’investigation avant de les généraliser.

Lire la démarche d’audit Datadog et AWS

Compétences techniques

APM et performance applicative

Suivre le temps de réponse, les erreurs et les dépendances sur un parcours critique. Relier une dégradation côté utilisateur aux services qui participent à la transaction.

Les sujets couverts

Cartographie des dépendances, traces distribuées, latence P95/P99, taux d’erreur, appels externes et requêtes de base de données.

Instrumentation OpenTelemetry

Définir les attributs de service, propager le contexte et rapprocher les traces des logs. Structurer la collecte et l’export vers les plateformes retenues.

Les sujets couverts

SDK ou instrumentation automatique selon les langages, Collector, pipelines de réception, traitement et export, conventions sémantiques et corrélation par identifiant de trace.

Supervision des infrastructures

Conserver une lecture de la disponibilité et de la capacité : systèmes, réseaux, cloud et plateformes de conteneurs. Rapprocher ces mesures de la santé des applications.

Les sujets couverts

Services cloud, Kubernetes, systèmes et réseaux ; mesures de saturation, dépendances, seuils et responsabilités d’exploitation.

Fiabilité, SRE et gestion des incidents

Définir les indicateurs de service, qualifier les alertes et organiser l’investigation. Mesurer ce que les utilisateurs vivent, puis capitaliser après l’incident.

Les sujets couverts

SLI, SLO, budgets d’erreur, criticité des alertes, runbooks, chronologie d’incident et analyse des causes racines (RCA).

Maîtrise des données et des coûts

Choisir ce qu’il faut collecter et conserver. Adapter l’échantillonnage, la rétention et les attributs pour garder des données exploitables et un coût maîtrisé.

Les sujets couverts

Cardinalité des métriques, échantillonnage des traces, filtrage des données sensibles, rétention et suivi des volumes ingérés.

Accéder à notre diagnostic en six questions →
Nos partenariats technologiques

Des liens reconnus avec les éditeurs

Des partenariats qui donnent du sens à notre expertise.

Retrouvez nos références auprès des éditeurs, les dates documentées et les preuves officielles. Notre accompagnement se construit ensuite sur les besoins techniques des équipes.

Datadog Partner Network

ADN Consulting, partenaire Advanced

Une reconnaissance datée et vérifiable, dans l’écosystème de l’observabilité.
Advanced

Hiérarchie Datadog en France

Standard → Advanced → Premier
PremierNiveau le plus élevé du programme
0*Aucun signalé en France dans la consultation communiquée
AdvancedNiveau officiel d’ADN Consulting
2
Logo ADN ConsultingADN Consulting
LEANOVIALeanovia
StandardPremier niveau qualifié du programme
Majorité des partenairesCatégorie la plus représentée dans la consultation de l’annuaire France (effectif exact non établi)

Consultation de l’annuaire Datadog France du 19/10/2026 : deux fiches Advanced identifiées (ADN Consulting et Leanovia).

Écosystème Centreon

Centreon : un partenariat officialisé en 2019

Une expertise de la supervision reconnue par une publication de l’éditeur.

Source officielle

Une histoire technique documentée

2015

Premiers projets Centreon documentés. Le communiqué de 2019 indique quatre années de pratique de Centreon EMS par ADN.

2019

Annonce officielle du partenariat. Centreon publie un communiqué daté du 15 octobre 2019.

Aujourd’hui

Une expertise de supervision à découvrir. Nos pages expliquent le cadrage, l’intégration et l’exploitation des solutions Centreon.

Actualités et événements Observabilité

ADN Consulting présent au Centreon Connect Lille

À Lille, ADN participe au rendez-vous de l’écosystème Centreon consacré au monitoring et à l’observabilité.

Lire le retour ADN →

Notre retour sur le Datadog Summit Paris 2025

Journée partenaires, ateliers et retours d’expérience : les regards techniques et commerciaux de l’équipe ADN se croisent à Paris.

Lire le retour ADN →

Nous étions au salon DASH Datadog 2025 à New York !

L’équipe ADN se rend à New York pour les deux journées de DASH : annonces, échanges techniques et rencontres avec l’écosystème Datadog.

Lire le retour ADN →

ADN Consulting, au 1er évènement européen de Datadog.

Mathieu, Thierry et Sébastien à Amsterdam : trois jours d’ateliers techniques et commerciaux consacrés à Datadog.

Lire le retour ADN →
Toutes les actualités ADN →
Notre équipe : pilotage, architecture, expertise et projets

Simon — Pilotage des projets Observabilité

Coordonne les projets Observabilité, les intervenants et le suivi des engagements.

Cédric — Direction de projet et transformation

Structure et pilote les projets de transformation, en reliant organisation, équipes et trajectoire technique.

Fanny — Accompagnement commercial Observabilité

Accompagne la qualification des besoins et a suivi le cursus Datadog destiné aux équipes commerciales.

Lamine — Architecte et expert Datadog

Intervient sur les architectures et les dispositifs d’observabilité Datadog.

Matthieu — Datadog, Dynatrace et observabilité applicative

Travaille sur la performance applicative et l’exploitation des signaux pour le diagnostic.

Manu — Centreon et supervision IT

Contribue aux architectures de supervision et à la définition de contrôles pertinents pour l’exploitation.

Emanuel — Expert supervision

Apporte son expertise des dispositifs de supervision des infrastructures et services IT.

David — Expert technique

Accompagne les analyses et les problématiques d’ingénierie technique.

Roland — Expertise technique et supervision

Contribue aux projets techniques et aux problématiques de supervision.

Cédric — Consultant APM

Travaille sur l’analyse des performances et le diagnostic des applications.

Pascal — Chef de projet Observabilité

Organise et suit les activités nécessaires à la conduite des projets Observabilité.

Mariam — Consultante Observabilité junior

Contribue aux travaux d’observabilité aux côtés de l’équipe technique.

Retrouvez nos zones d’intervention et nos implantations.

Avant de démarrer : vos questions pratiques

Faut-il remplacer nos outils pour améliorer notre observabilité ?

Pas nécessairement. ADN Consulting examine d’abord vos usages, la couverture des services, les données disponibles et les coûts. La trajectoire peut consister à mieux exploiter l’existant, compléter l’instrumentation ou faire évoluer un outil sur un périmètre ciblé.

Peut-on commencer par un audit ou un POC ?

Oui. Un audit permet d’établir l’état des lieux et les priorités. Un POC permet d’évaluer une solution sur un périmètre représentatif. Nous définissons ensemble les objectifs, les accès nécessaires, les livrables et les critères de réussite.

Comment choisir entre Datadog, Dynatrace, Centreon et les autres solutions ?

Le choix dépend des services à suivre, des environnements techniques, des usages des équipes et du coût global. Nous examinons les besoins de supervision, de performance applicative et d’analyse des signaux pour construire des critères de comparaison et, si nécessaire, un POC.

Pouvez-vous intervenir avec notre équipe et nos prestataires actuels ?

Oui. L’intervention peut prendre la forme d’un projet défini, d’un renfort ciblé ou d’un centre de services sur un périmètre convenu. Le cadrage précise les responsabilités, les accès, les interlocuteurs et le transfert de compétences.

Comment sont définis le périmètre, les livrables et le budget ?

Nous partons de votre situation, de vos objectifs et de l’existant. Les services concernés, les contraintes, les livrables, les modalités d’intervention et les critères de recette permettent de construire une proposition adaptée. Le budget est établi à partir de ce périmètre.

Comment mesure-t-on les améliorations obtenues ?

Nous définissons un état initial et des indicateurs adaptés au besoin : couverture des services, pertinence des alertes, délais d’investigation, disponibilité ou coûts de collecte. Les résultats sont examinés sur le périmètre convenu, sans promettre un gain universel.

Pourquoi une application ralentit-elle alors que les serveurs semblent fonctionner ?

Un serveur disponible peut héberger une application qui attend une requête SQL, un appel externe ou une ressource partagée. Nous partons d’un parcours utilisateur et de l’heure du ralentissement, puis rapprochons traces, erreurs et métriques pour orienter les vérifications.

Comment détecter une panne avant les remontées des clients ?

Il faut surveiller la réussite des parcours importants, pas seulement l’état des serveurs. Des contrôles de disponibilité, des mesures côté application et des alertes liées à l’impact utilisateur se complètent. Nous examinons d’abord la couverture existante et les étapes qui restent invisibles.

Comment trouver plus vite la cause d’un incident ?

Commencez par situer l’impact et la chronologie, puis suivez les dépendances du service. Les logs, métriques et traces servent à vérifier les hypothèses. Une procédure partagée évite que chaque équipe reparte de zéro et permet de conserver les éléments utiles à l’analyse après rétablissement.

Comment réduire les alertes inutiles ?

Examinez les alertes qui reviennent, celles qui ne déclenchent aucune action et celles qui arrivent trop tard. Seuils, regroupements, périodes de maintenance et destinataires doivent être revus ensemble. Chaque modification se vérifie pour conserver la détection des incidents importants.

Pourquoi les voyants sont-ils verts alors que l’activité est bloquée ?

La disponibilité des composants ne garantit pas la réussite d’un traitement métier. Il faut suivre les étapes du parcours, les erreurs et le résultat attendu : commande terminée, fichier reçu ou traitement achevé. Cette lecture complète la supervision technique.

La lenteur vient-elle du code, du réseau ou de la base de données ?

Une trace applicative aide à repérer où le temps est passé. Elle se complète avec les mesures de la base, du réseau et des services appelés. Un temps d’attente élevé indique une piste ; il faut vérifier les mesures du composant concerné avant de conclure.

Quels indicateurs suivre pour la fiabilité d’un service ?

Suivez notamment la réussite des parcours, les erreurs, la disponibilité et les temps de réponse, y compris les requêtes les plus lentes. Les objectifs de service doivent refléter les attentes des utilisateurs. Un indicateur n’est utile que si l’équipe sait quelle décision prendre lorsqu’il se dégrade.

Comment choisir entre Datadog, Dynatrace, Centreon et Splunk ?

Comparez les outils sur vos propres scénarios : supervision d’équipements, parcours applicatifs, recherche dans les logs ou exploitation quotidienne. Évaluez aussi les intégrations, les compétences nécessaires et le coût des volumes prévus. Un POC sur les mêmes critères permet de comparer des résultats utiles à vos équipes.

Faut-il remplacer notre supervision pour faire de l’observabilité ?

Pas nécessairement. Nous examinons ce que vos outils permettent déjà de voir et les informations qui manquent pour investiguer. Il peut suffire de mieux relier les signaux, de compléter l’instrumentation ou de revoir les usages avant d’envisager un changement de plateforme.

Comment préparer un POC d’observabilité ?

Choisissez un service représentatif et quelques questions auxquelles le POC doit répondre. Définissez les accès, les données autorisées, les scénarios, la durée et les critères de décision. La restitution doit présenter les résultats, les limites rencontrées et les conditions d’un éventuel déploiement.

Certifications obtenues dans nos parcours

Certifications et développement des compétences

La certification, la formation et la pratique accompagnent nos parcours en observabilité.

Datadog

  • Technical Specialist
  • Support
  • APM & Distributed Tracing Fundamentals

Dynatrace

  • Associate

Centreon

  • Certification Centreon

Formation continue

Datadog Fundamentals · Formation Centreon · Ateliers techniques et pratique en laboratoire

Parlons de votre contexte

Un incident récurrent, un outil à faire évoluer ou une équipe à renforcer ? Échangeons sur votre situation.

Nous contacter

Échangeons sur vos enjeux

Expliquez-nous simplement votre contexte. L’équipe ADN Consulting reviendra vers vous.

Vous pouvez aussi nous écrire :

contact@adn-consulting.fr

* Champs nécessaires. Pas d’inscription à une newsletter. Ne transmettez aucune donnée confidentielle.