Ansible permet de décrire et d’exécuter des opérations de manière reproductible, de la configuration d’un serveur au déploiement d’un service. La réussite ne se mesure toutefois pas au nombre de playbooks, mais au temps gagné et au risque réellement réduit.
Choisir un premier cas d’usage stable
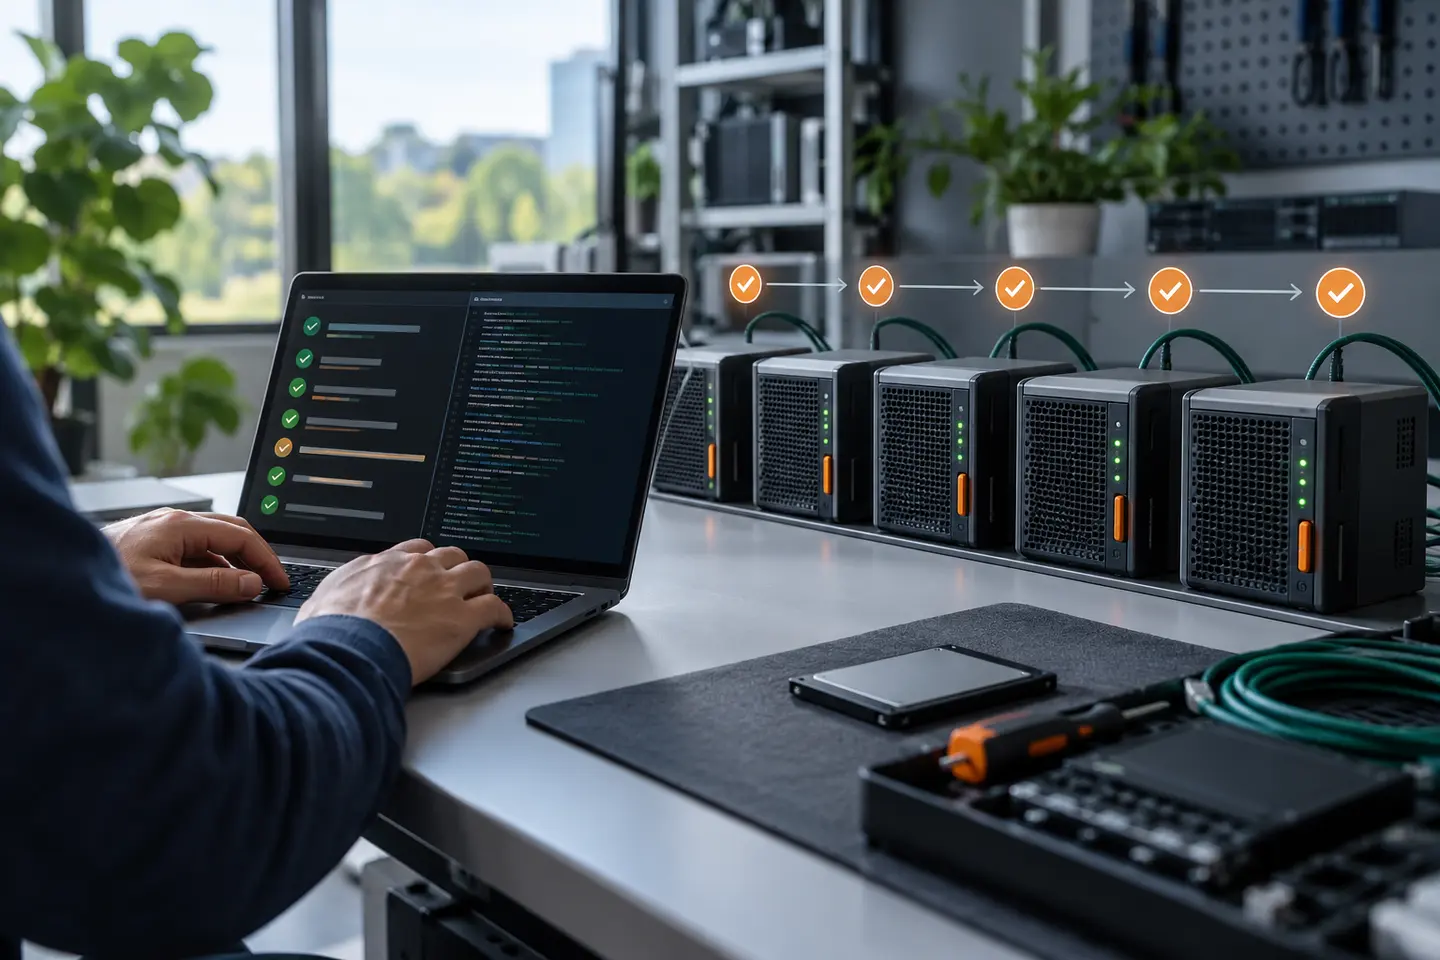
Une bonne cible est fréquente, documentable et suffisamment prévisible : création d’un compte technique, contrôle de configuration, installation d’un agent ou préparation d’un environnement. L’équipe décrit l’état attendu, les prérequis, le retour arrière et les preuves de réussite. Les tâches sont conçues pour être idempotentes, testées sur un périmètre réduit et versionnées avec une revue de code. Les secrets sont confiés à un mécanisme dédié plutôt qu’inscrits dans les variables.
Passer du script utile au service d’automatisation
Quand l’usage s’étend, il faut organiser les rôles, les inventaires, les dépendances et les droits d’exécution. Des contrôles automatiques vérifient la syntaxe, les bonnes pratiques et le résultat attendu. Une interface ou un contrôleur peut ouvrir l’automatisation à d’autres équipes sans leur donner un accès direct aux systèmes. Le suivi porte alors sur le taux de réussite, le temps économisé, les écarts détectés et les incidents évités — pas seulement sur le nombre de tâches lancées.
À retenir
L’automatisation Ansible devient durable quand un cas d’usage maîtrisé évolue vers un service versionné, testé et mesuré.
Pour approfondir
Red Hat — Ansible Automation Platform ↗Documentation Ansible ↗Article mis à jour le . La date de première publication est conservée.