L’intelligence artificielle ne transforme plus seulement le développement ou les usages métiers. Elle commence aussi à modifier la manière dont les systèmes d’information sont supervisés. Les évolutions récentes de Splunk autour d’Agent Observability illustrent cette tendance : l’observabilité doit désormais suivre non seulement les infrastructures et les applications, mais aussi les agents IA eux-mêmes.
Observer les agents IA comme des composants critiques
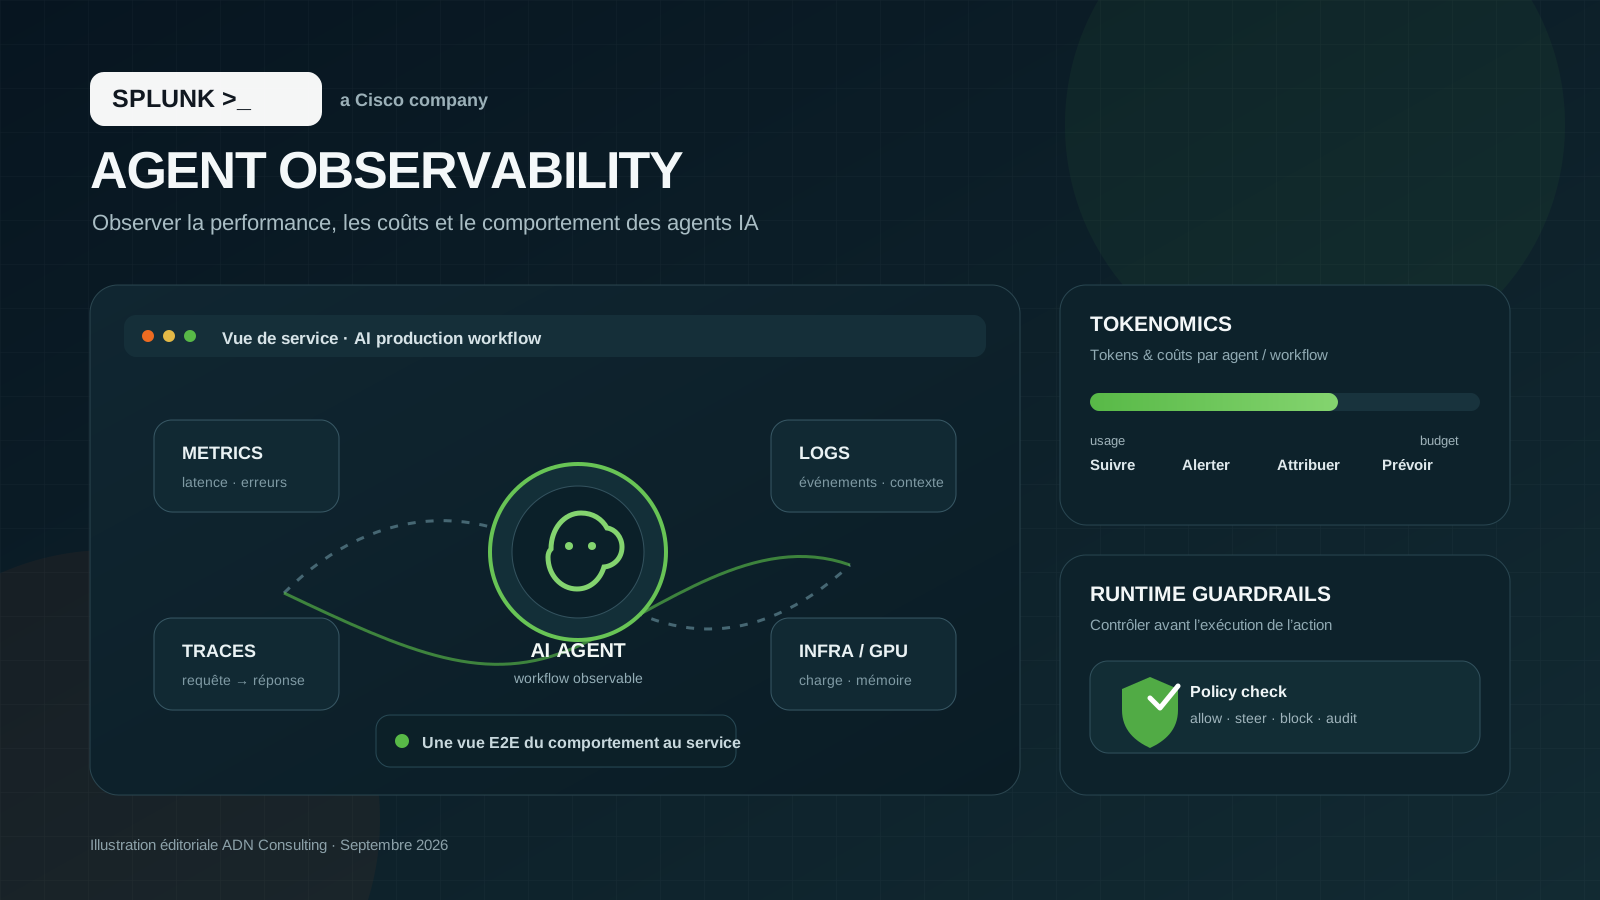
Un agent IA peut interroger plusieurs modèles, accéder à des données, appeler des outils et enchaîner des actions de manière autonome. Pour les équipes IT, de nouvelles questions apparaissent : que fait réellement l’agent, pourquoi a-t-il déclenché une action, où se situe la latence et quel modèle a été sollicité ? Avec Agent Observability, Splunk étend la visibilité aux workflows agentiques et les relie aux couches techniques sous-jacentes. L’agent devient ainsi un composant de production à superviser au même titre qu’une API, un service ou une plateforme Kubernetes.
Tokens, coûts et comportements deviennent des signaux d’exploitation
Aux métriques traditionnelles — disponibilité, temps de réponse, CPU, mémoire ou erreurs — s’ajoutent désormais la consommation de tokens, le modèle utilisé, le coût d’un traitement et des indicateurs de qualité. Splunk met en avant le suivi de ces consommations par agent, requête ou workflow. Pour l’exploitation, l’enjeu est concret : un service peut fonctionner correctement tout en générant une consommation IA excessive. L’observabilité doit donc rapprocher performance, qualité et coût afin de rendre les dérives visibles avant qu’elles ne deviennent un problème opérationnel ou budgétaire.
Observer, mais aussi encadrer les actions
L’autre évolution concerne les guardrails. Splunk propose des contrôles capables d’intervenir pendant l’exécution afin de bloquer ou réorienter certaines actions à risque, par exemple face à une fuite de données sensibles, une injection de prompt ou un mauvais usage d’un outil. Ces mécanismes peuvent aussi être déployés dans des environnements privés, y compris en VPC ou totalement isolés. L’observabilité se rapproche ainsi de la sécurité et de la gouvernance : voir ce que fait un agent ne suffit plus, il faut aussi pouvoir vérifier et encadrer son comportement.
Quel impact pour le MCO et les IT Ops ?
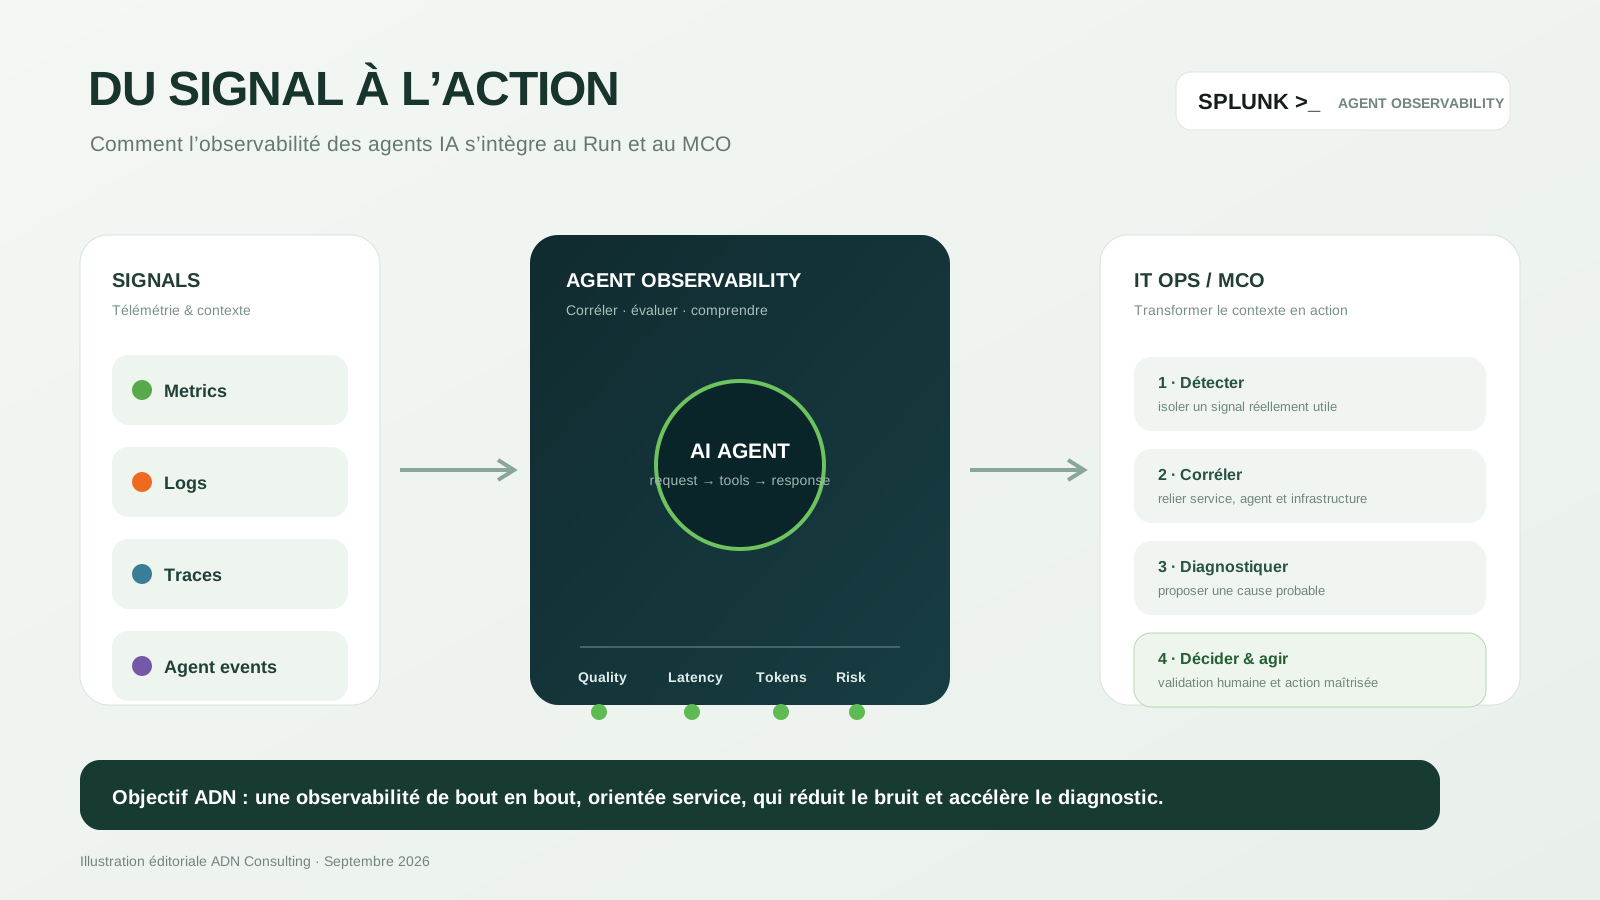
Cette évolution dépasse la seule supervision de l’IA. Les mêmes données peuvent aider les équipes d’exploitation à corréler plusieurs signaux, isoler une dépendance, rapprocher un événement d’infrastructure d’un comportement applicatif et accélérer la recherche de cause probable. Le fonctionnement traditionnel — alerte, analyse, diagnostic, action — évolue progressivement vers une chaîne où détection, corrélation et diagnostic sont davantage assistés. Pour le MCO, l’objectif reste le même : réduire le bruit, comprendre plus vite l’impact sur le service et concentrer l’expertise humaine sur les décisions qui nécessitent réellement du contexte.
Retour en images
À retenir
L’arrivée des agents IA élargit le périmètre de l’observabilité. Performance, comportement, sécurité et coût doivent désormais être lus ensemble, dans une vision de bout en bout orientée service.
Pour approfondir
Splunk — Agent Observability ↗Splunk — nouveautés Observability Cloud de septembre 2026 ↗Splunk — Runtime AI Guardrails ↗ADN Consulting — notre expertise Observabilité →Article mis à jour le . La date de première publication est conservée.