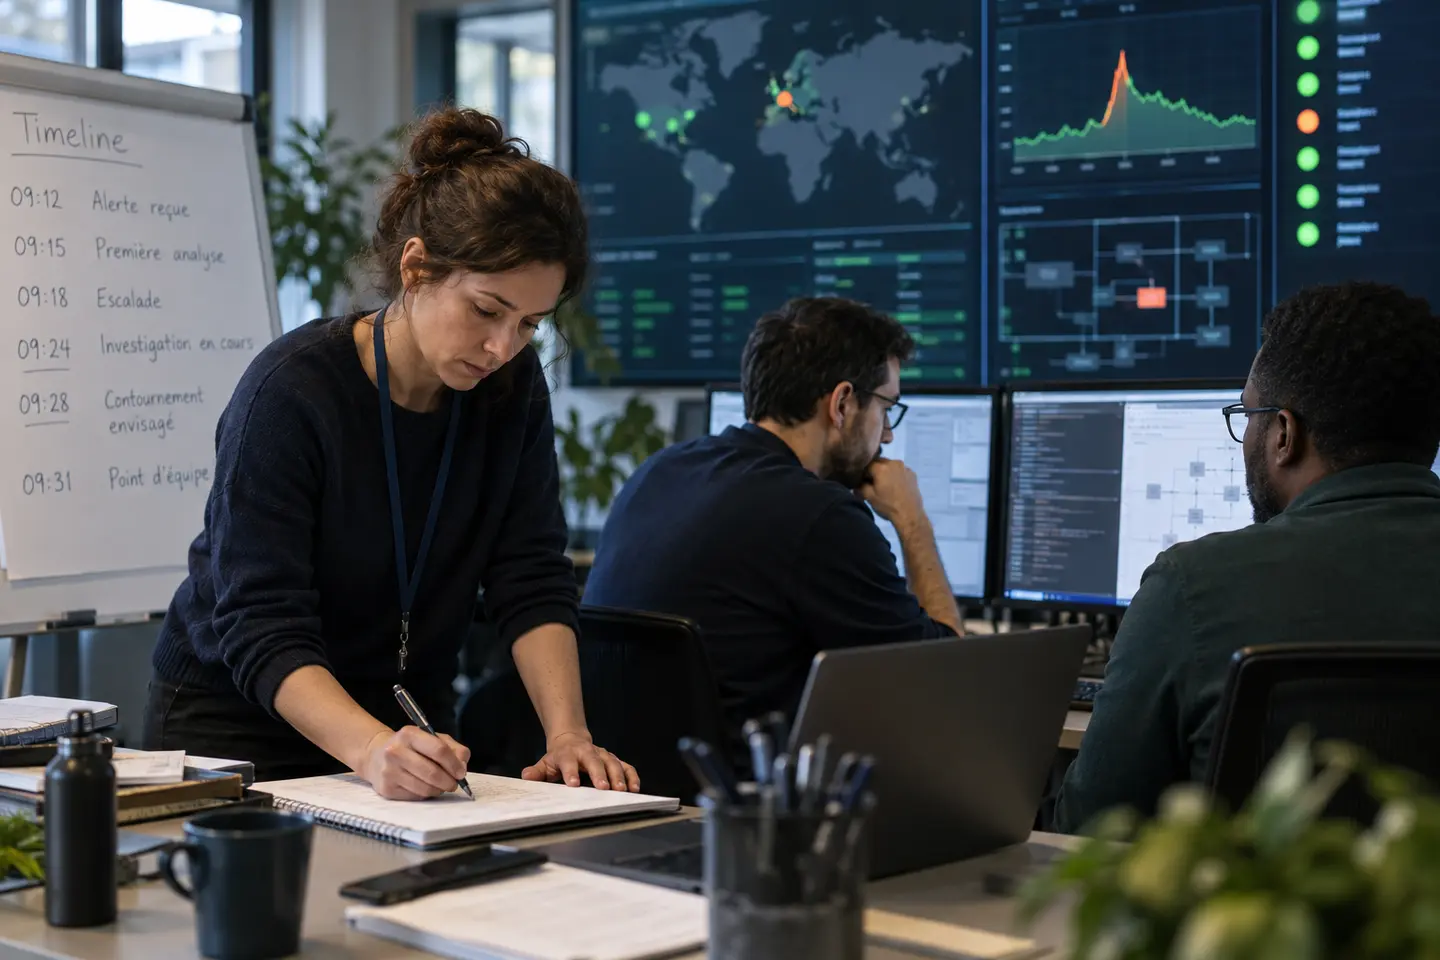
Lors d’un incident critique, chaque minute compte, mais aller vite ne signifie pas agir sans cadre. Une séquence commune aide l’équipe à confirmer l’impact, stabiliser la situation et rapprocher les signaux jusqu’à une cause probable suffisamment solide pour décider.
Séparer impact, symptômes et hypothèses
Le premier signal peut venir d’une alerte, d’un utilisateur ou d’un indicateur métier. L’équipe qualifie d’abord le périmètre touché : services, populations, régions et changements récents. Elle ouvre ensuite une chronologie unique et attribue des rôles clairs — coordination, diagnostic, communication et décision. Les observations restent distinctes des hypothèses. Cette discipline évite qu’une intuition précoce devienne une conclusion et permet de garder les actions réversibles.
Corréler avant de conclure
La recherche progresse en reliant événements de déploiement, métriques de service, traces, logs et dépendances. Chaque hypothèse doit produire un test court : comparer une version, isoler un nœud, désactiver une fonctionnalité ou reproduire un appel. Une cause probable n’est pas nécessairement la cause racine définitive ; elle est l’explication la mieux étayée qui permet de rétablir le service avec un risque maîtrisé. L’analyse approfondie vient ensuite, à froid. Les apprentissages utiles alimentent alors les contrôles, la documentation et les actions de prévention.
À retenir
Un diagnostic rapide combine une chronologie commune, des rôles explicites et des hypothèses testables fondées sur des signaux corrélés.
Pour approfondir
Datadog — Incident Management ↗Google SRE — gestion des incidents ↗Article mis à jour le . La date de première publication est conservée.