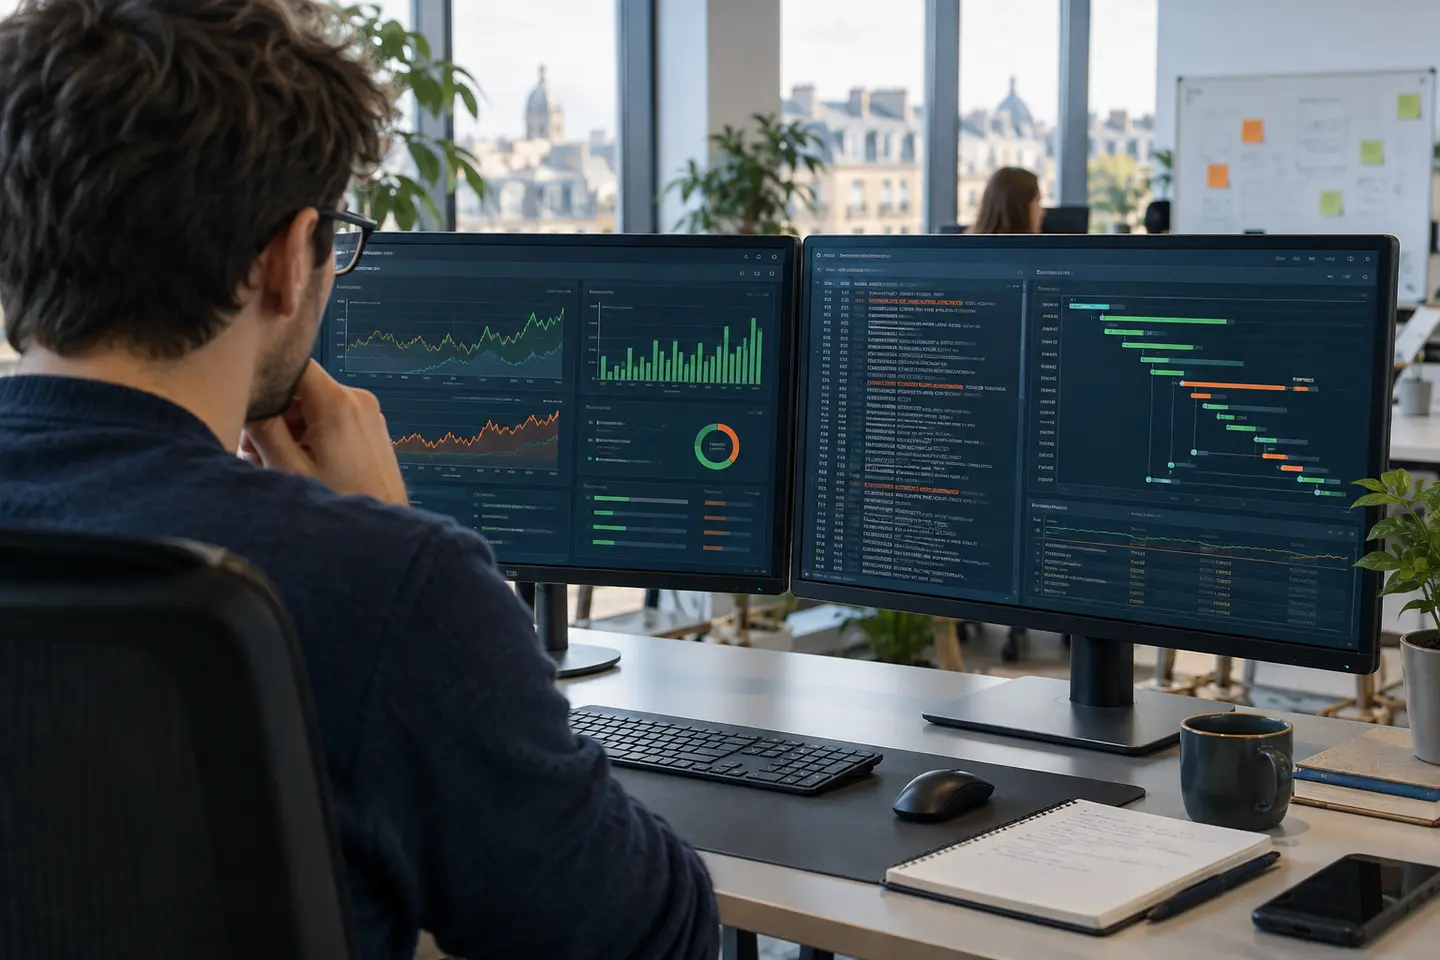
Pendant un incident, la difficulté n’est pas toujours de collecter davantage de données. Elle consiste surtout à passer rapidement d’un signal visible à une hypothèse vérifiable. Relier métriques, logs et traces dans Datadog permet de conserver le même contexte tout au long du diagnostic.
Commencer par le service et son impact
Une hausse de latence n’a de sens que si l’on sait quel service, quel parcours et quels utilisateurs sont concernés. Le premier travail consiste donc à définir des conventions communes : nom du service, environnement, version, équipe responsable et identifiant de corrélation. Ces attributs doivent suivre la requête entre l’application, l’infrastructure et les journaux. Sans ce socle, les écrans restent riches mais les passages d’un signal à l’autre demeurent manuels.
Construire un chemin de diagnostic reproductible
Le cas d’usage le plus simple part d’un indicateur de service dégradé, ouvre les traces les plus lentes, puis isole les logs produits au même instant. L’équipe peut alors comparer une version, une zone ou une dépendance avant d’agir. Les tableaux de bord servent à orienter cette enquête ; ils ne remplacent ni les responsabilités ni les procédures d’incident. L’objectif est un parcours court, compréhensible par plusieurs rôles et régulièrement testé. Un exercice à froid permet d’en vérifier la fluidité avant une situation critique.
À retenir
Une corrélation utile repose d’abord sur un contexte commun et un chemin de diagnostic partagé, pas sur l’accumulation de widgets.
Pour approfondir
Datadog — présentation de la plateforme ↗Documentation Datadog ↗Article mis à jour le . La date de première publication est conservée.